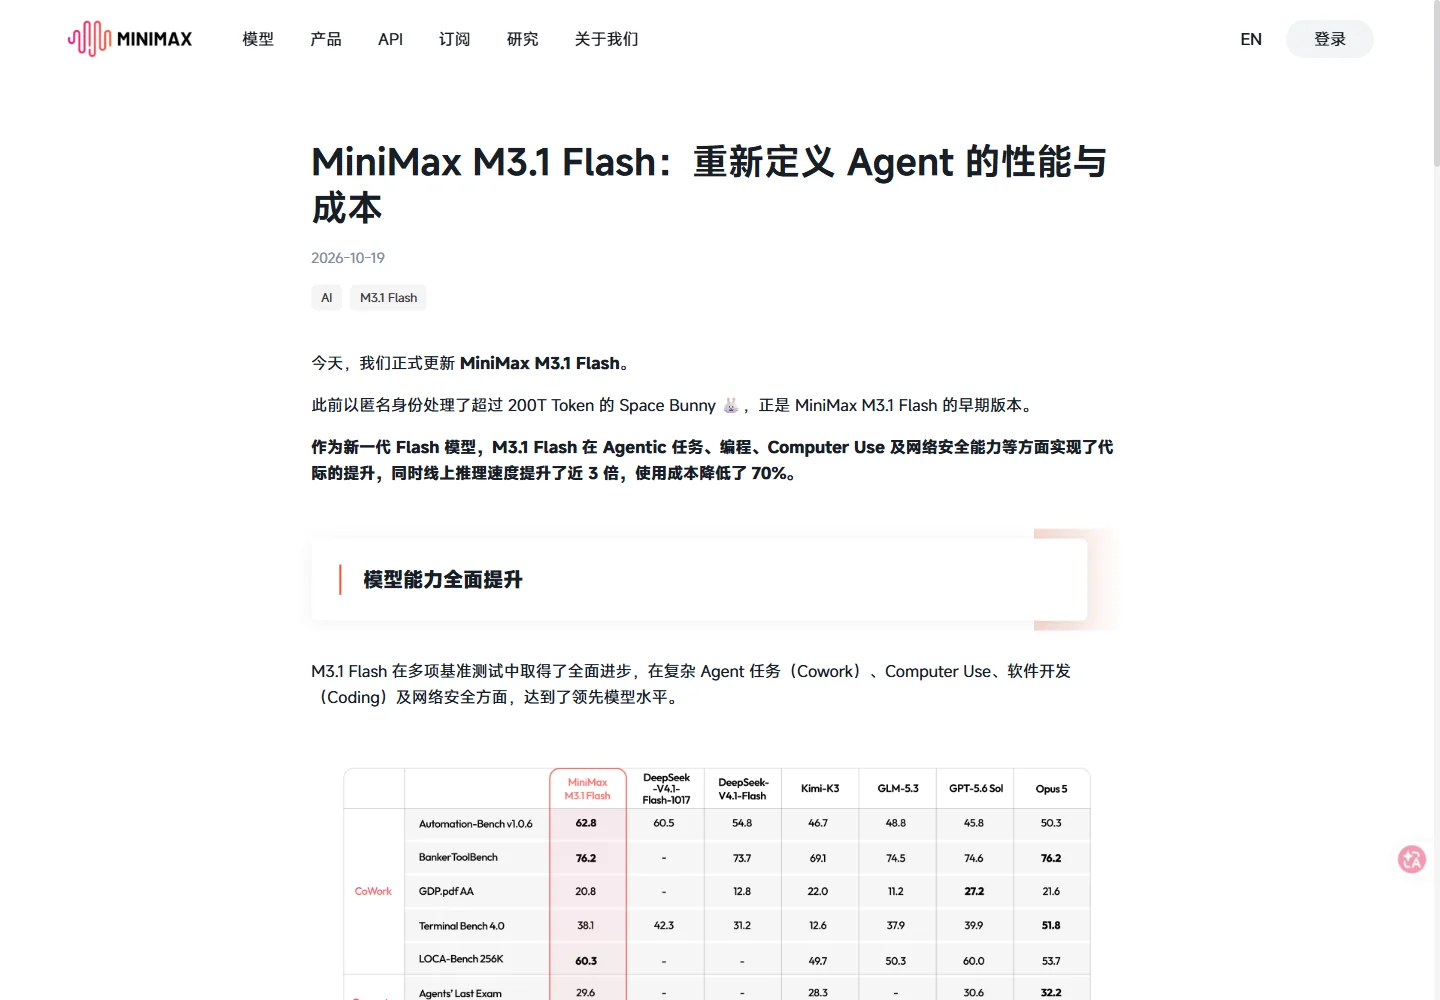
MiniMax M3.1 Flash 最值得关注的是:做代码和多步骤任务的能力上去了,生成速度也更快。官方公布的日常输出速度可达 200+ token/s,中位数达到 170+ token/s;线上推理速度接近上一代的 3 倍。
它已经能通过 MiniMax Code 和 API 使用。想先体验,下载桌面版就能开始;想接进自己的工具,下面也列了需要填写的配置。
它强在哪里,适合拿来做什么?
这次提升主要落在改代码、调用工具、连续完成多步任务上。比如读懂一个项目、找到报错、修改文件,再运行测试,而不是只给一段建议。
官方公布的 DeepSWE v1.1 成绩是 73.7%。这个测试关注代码理解、功能开发、修复问题和验证结果,MiniMax 将其表现列为顶尖模型水平。上面的速度与成绩都来自 10 月 19 日发布公告,本站没有做同条件排名测试。
对个人用户,最容易感受到差别的任务是:给一个小项目修 bug、批量处理文件、把多份资料整理成报告。支持的材料包括文本、图片和视频;当前文档列出的上下文是 100 万 token,可以理解为一次任务能容纳的材料和对话空间。
最快上手:下载 MiniMax Code
- 打开 MiniMax Code 官方下载页,选择 Windows 或 macOS,按安装程序提示完成安装。
- 打开软件并登录,查看当前账号的模型选项和可用额度,确认使用的是 M3.1 Flash。
- 新建任务。要处理本地代码或文件时,选择对应文件夹;只整理文字时,直接提供材料。
- 发出一个范围明确的小任务,检查它的结果,再继续扩大工作量。
例如,给一个已经有测试的小项目,复制下面这段要求:
先读这个项目,找到导致下面报错的原因。给我最小修复方案,然后修改相关文件并运行已有测试。最后说明改了哪里、哪些测试通过;没有跑过的不要说通过。报错是:【粘贴报错原文】。
官方页面也提供 网页端入口。桌面端适合需要使用本地文件和工具的任务,具体额度按账号的订阅或计费方式显示。
已有客户端:把这三项填进去
如果工具支持 OpenAI 兼容接口,新增一个自定义提供商,填入中国站这一套配置:
| 设置项 | 填写内容 |
|---|---|
| Base URL / 接口地址 | https://api.minimax.cn/v1 |
| 模型名 | MiniMax-M3.1-Flash |
| API Key | 在 MiniMax 开放平台取得、适用于当前计费方式的密钥 |
保存后先发一句“用一句话解释什么是 API”,确认能正常回复,并到平台查看用量记录。中国站的地址和密钥要配套;国际站账号使用 https://api.minimax.io/v1。更多协议配置见 官方调用文档。
大概要花多少钱?能下载到本地跑吗?
中国站按量 API 的公开价格为:每百万 token 输入 1 元、输出 4 元、缓存读取 0.1 元。按这个单价,20 万普通输入加 5 万计费输出,模型费用约 0.40 元;这是计算例子,不是本站测试账单。订阅额度与按量 API 分别看各自规则,调用前以 官方价格页为准。
本地部署还要等权重发布。10 月 19 日公告写的是“稍后开放权重”,当前本文介绍的是云端模型的使用入口。下载 MiniMax Code 是安装客户端,模型计算仍由服务端完成。
回复慢或报参数错误时,再看这个设置
M3.1 Flash 默认使用 max 思考档位,支持 low、medium、high、xhigh、max,不能关闭思考。支持该选项的客户端里,简单任务可以先试 low。OpenAI 兼容协议对应 reasoning_effort,不要传 none;Anthropic 兼容配置见官方文档。
资料核对:2026-10-23。未执行付费 API 对比测试。