“用中文向初学者解释 Python 字典与列表的区别。”
这条短问题,在本地跑出了 512 token 的回答,整个请求用了 3.61 秒。显卡是 RTX 4070 Ti,只有 12GB 显存;模型却是 27B 稠密模型。
这组数字,是这次折腾最值得留下来的东西。12GB 卡能把这样一个模型跑到短回答超过 100 token/s,本地聊天就有了试一试的吸引力,尤其是你本来就有这张卡的时候。
先把名字说准:这里运行的是 Qwen3.8-27B 衍生的 Bonsai 2 三元模型,用了更省显存的权重和 NInfer 引擎。速度记录来自 2026 年 10 月 3 日;下面给出的 Windows 图形安装路线,方便先跑通聊天,但与当时测速不是同一套权重配置。
147 和 229 token/s,分别是怎么来的
同一台 RTX 4070 Ti 12GB、约 32GB 内存的电脑,用短输入测了中文回答和代码生成,记录如下:
| 任务 | MTP 配置 | DFlash2 配置 |
|---|---|---|
| 中文回答 | 约 107 token/s | 约 147 token/s |
| 代码生成 | 约 123 token/s | 约 229 token/s |
开头的 3.61 秒,就是 DFlash2 那次中文请求。表里的数字是解码速度,也就是模型开始生成后输出 token 的速度;token 不能直接换成汉字。代码那次输出 362 token,整个请求约 1.70 秒。
这已经足够让人想把本地问答、改写和小段代码生成拿来试试了。但跑得快,回答不一定就对;这组记录也没有证明它在质量上胜过云端旗舰模型。
还有个容易失望的地方:把短问题换成长文档,速度会变。约 44K token 输入时,读入材料用了约 38 秒,之后解码约 84 token/s;约 128K 输入时,读入约 233 秒,解码约 60 token/s。拿它读长材料,要把这段等待一起算进去。
想在自己的 Windows 上试,先认准这两个下载
下面按 Local Models 0.4.1beta 来装。需要 64 位 Windows 11 和 NVIDIA RTX 30、40、50 系列显卡;这套启动器不适用 AMD、Intel 或更老的 GTX。项目说明要求 CUDA 13.x 对应的 NVIDIA 驱动至少为 580,旧驱动报错时先检查这里。
12GB 显存别只看模型名称,还要看文件名里的显存档位。本文机器有约 32GB 系统内存;下方模型包标注 ram16g,实际还得给 Windows 和其他程序留空间。磁盘也要装下约 7.13GB 的模型、引擎和程序。
安装程序:选 Setup
进入 0.4.1beta 发布页,展开 Assets,下载 LocalModels-Setup-0.4.1beta.exe。第一次安装用它;Update 给已经安装的人更新,Source code 是源码。
模型文件:先选标着 10GB 显存的这一份
打开作者给的 123 云盘,进入“模型包”文件夹,找:
Ternary-Bonsai-2-27B-ninfer-v3-mtponly_vram10g+ram16g.ninfer
文件名很长,真正要看的是 mtponly_vram10g+ram16g。它是先跑通聊天用的 MTP-only 包,10 月 23 日核对时约 7.13GB。目录里标着 16GB、20GB 显存的版本,12GB 卡先别选。
这份现成模型包,不是上表的 CRACK PQ2 测速权重。它省掉了自己转换和合并模型的步骤;本文还没对这个安装组合重新测速,所以装好以后有多快,要以你的实际输出为准。
装好后,先让它开口回答一句
- 运行 Setup,跟着向导安装。在“硬件检查”确认显卡型号正确。
- 到“引擎包”页面,下载它为显卡匹配的引擎。普通安装不需要自己配 Python、Node.js 或编译环境。
- 安装完成,把下载的
.ninfer文件复制到安装目录的models文件夹。
默认位置如下;安装时换过目录,就用你自己的路径:
C:\Program Files\Local Models\models\打开 Local Models,进入控制模型,点载入模型。等日志显示载入成功,再点打开模型,或在浏览器输入 http://127.0.0.1:8096/。
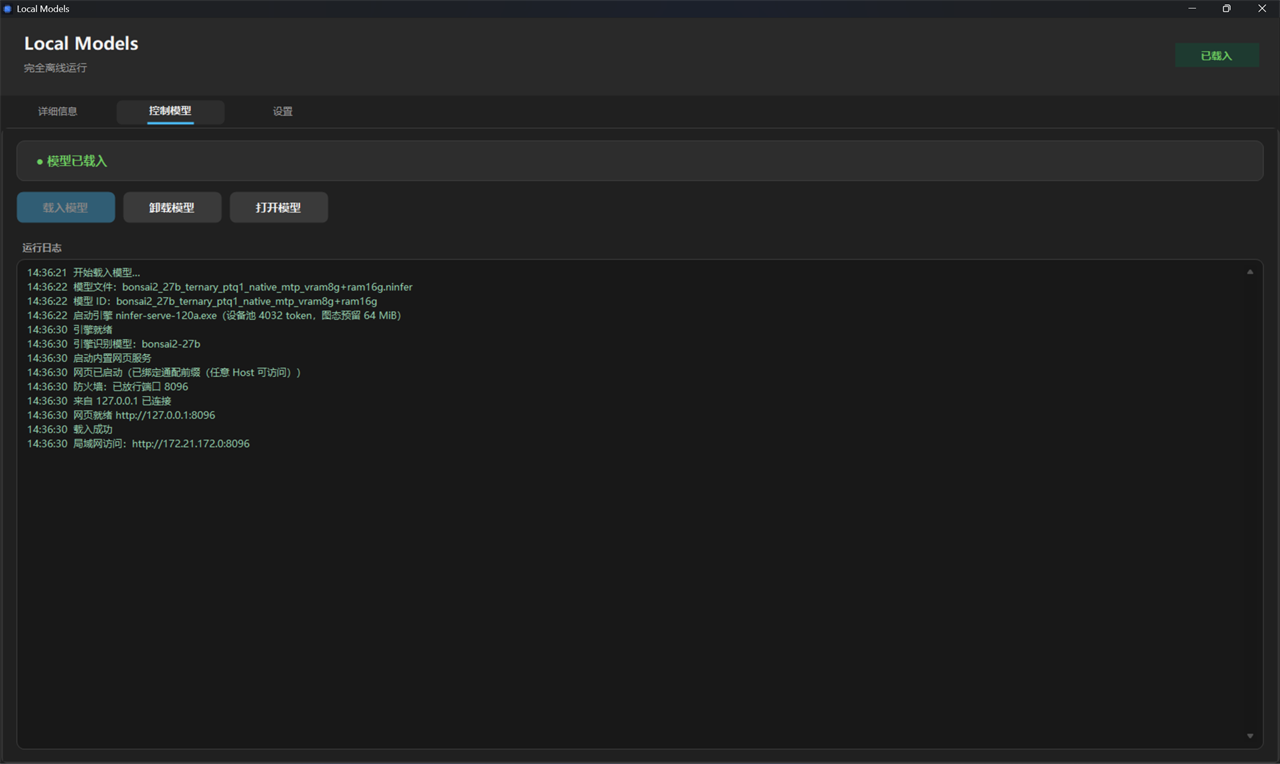
第一次不用长文档,先输入:
用三句话解释大模型的 token 是什么,再给一个适合零基础读者的例子。不要堆专业术语。
能回复了,再试你真正想做的事。比如让它写一个只用 Python 标准库、统计 CSV 各列空值的脚本,要求带运行方法和输入输出例子。把脚本跑一下,比不停问“你是什么模型”更能判断它能不能帮上忙。
磁盘 KV 缓存先保持默认关闭。等短对话顺畅后,再一点点增加材料长度。窗口收起来时,程序可能还在系统托盘里,并没有退出。
卡住时,先看日志,别急着重装
模型列表是空的:检查文件是否真的放进安装目录的 models 文件夹,后缀是不是 .ninfer。压缩包要先处理好,GGUF 也不能改个后缀就用。
显存不足:关掉其他占显存的程序,核对是不是误下了 16GB 或 20GB 档。模型能装进硬盘,不代表启动时一定装得进显存。仍失败时,保留“控制模型”里的完整报错和显卡型号,再向项目维护者反馈。
网页打不开:先看模型是否载入成功、启动器是否还在运行,再检查本机地址和端口。载入已经失败时,反复刷新聊天页面没有用。
测速条件、100+ token/s 的边界,以及三个 GitHub 项目
2026-10-03 的记录使用 Bonsai 2 CRACK PQ2 衍生权重、NInfer KVMem 20261002 sm89 引擎。单请求、temperature=0、关闭思考;比较 MTP3 与 DFlash2 K12 两套配置,常驻窗口 16K、逻辑上下文 262144。
两套配置的 GDN 状态精度、分块和草稿后端等并不完全相同,生成长度也可能不同,所以不能把全部差值算作 DFlash 的单独收益。这是历史单次任务记录,不是最新版或长时间平均成绩。
历史 Cline、OpenCode 任务还出现过重复工具调用,本文没有新的证据确认已经解决。速度、普通对话和稳定执行工具,需要分别检查。
完整测速条件与原始请求记录在这里。想看实现,几个项目的分工是:
- TinyDX/local-models:这篇使用的 Windows 图形启动器。
- ninfer-fusion-kvmem:融合了缓存和推理优化的引擎项目。
- NInfer:上游推理引擎。模型来源可对照 Bonsai 2 模型说明。
启动器项目和 0.4.1beta 发布文件于 2026-10-28 复核。网盘模型档位记录来自 10-23,测速来自 10-03;本文没有把历史速度标为当前安装组合的成绩。