熊猫爬上石柱,走到了平台边缘。到这里,给它一顶滑翔伞,故事就能拐向另一个方向。
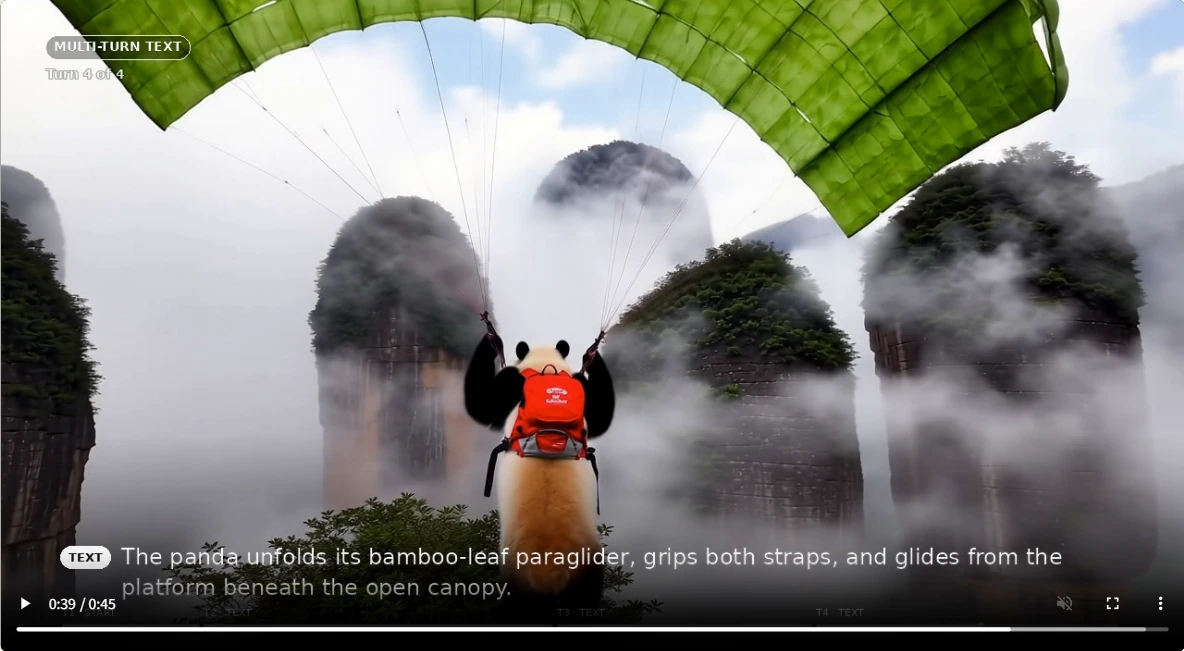
腾讯混元 Hy-Nomas 的官方演示里,第四轮指令真的安排了这件事:熊猫展开竹叶滑翔伞,背着红色背包飞进云雾。前面还是攀爬,后面突然有了冒险片的味道。
好玩的地方就在这一轮。不用把后面所有剧情提前想好,看到已经生成的画面,还能继续决定下一段发生什么。Hy-Nomas 把文字和镜头控制接进多轮视频生成,代码和模型权重也已经公开。
故事拍到一半,还能改主意
这段熊猫视频一共用了四轮:先设定云雾、石柱和红背包熊猫,再让它向上攀爬,接着走向平台边缘、加入蝴蝶,最后才展开滑翔伞。
把它放到自己的题材里,思路就很清楚了。先让宇航员在月球基地里走几步,看看环境和人物,然后临时加一句“左边开来一辆月球车”。你可以根据眼前的画面续写,也能在文字指令之间调整相机路径。
这让分镜预演有了点边拍边想的空间。一个动作成立了,再往下接;想换机位,就试着绕过去看。做短片概念、探索场景或交互原型,都能从这种连续变化里得到反馈。
当然,连续生成最怕前后接不上。镜头转回来,刚才的建筑还在不在?人物的背包有没有换颜色?官网专门展示了空间记忆样片,但这不等于所有提示词都能稳定延续。自己生成时,这些细节得盯住。
官方页面给出的规格是 720p、最长 60 秒;模型卡里的 24 FPS 指视频播放帧率,不能拿它当生成速度。产物仍是视频,完整游戏需要的碰撞、任务和交互逻辑,还要另做。
先去网页里造一个小场景
第一次体验,直接打开 Hy-Nomas 在线 Demo。页面下方的 World gallery 可以先看现成世界;想自己生成,按页面登录提示进入。
表单里主要填两项:Environment Description 是环境,Subject Description 是人物或主体。视角 Perspective 先选 Third person,就能从外面看着角色走。
可以先用这组简单设定。环境是:
An abandoned moon base with glass corridors, distant mountains, and Earth above the horizon.
主体是:
An astronaut in a white spacesuit carrying a small orange backpack.
也就是废弃月球基地、玻璃走廊、地平线上的地球,加上一名背橙色小背包的白衣宇航员。点 Enter world,等第一段出来,再给下一轮:
A small rover approaches the astronaut from the left.
先只让月球车从左边靠近。看看它能不能顺着刚才的画面出现,宇航员和背包是否还接得上。接住了,再加镜头移动;刚开始就同时换天气、换衣服、加车辆,很难判断哪里出了问题。
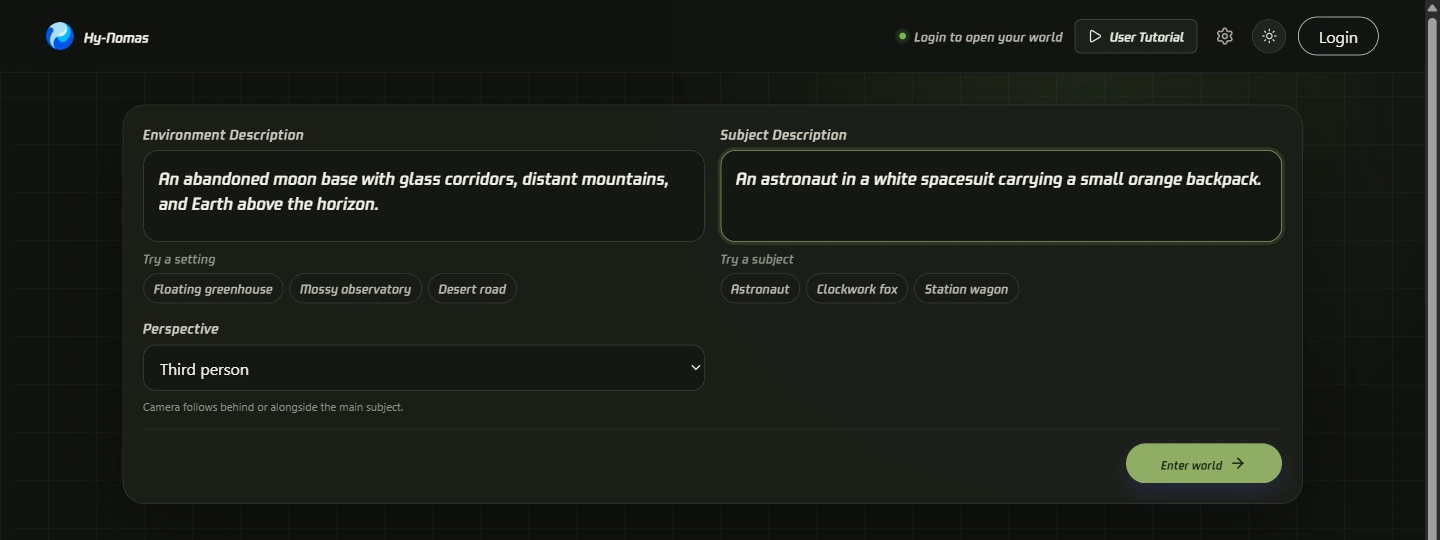
需要移动镜头时看 Camera path,操作说明在 User Tutorial。完成后用 Download 保存视频,想重来则用 New world。上面的月球场景是尝试模板,本站尚未验证生成效果;登录后的额度、排队和耗时看页面当时的状态。
开源之后,已经有人把它接进常用工具
腾讯放出的内容挺完整:GitHub 仓库包含推理、训练、LoRA 微调和交互网页代码;Hugging Face 模型页提供基础版、蒸馏版、量化权重等文件。代码和腾讯发布的权重采用 Apache-2.0,第三方组件按各自许可使用。
更值得追的是后面长出来的用法。官方仓库 10 月 25 日记录了 WanGP v18.81 接入:可以用键盘探索世界、输入事件,还能保存探索进度再回来继续。原来只是在演示里看一眼的东西,开始有了可以接着玩的入口。
已经在用 ComfyUI 的话,也有 ComfyUI-Hy-Nomas 社区节点。它提供连续片段工作流和 WASD 镜头控制。可以在 ComfyUI-Manager 搜索 Hy-Nomas (world model),安装并重启,再按仓库 Quick start 下载配套权重,从 Hy-Nomas world (per segment).json 工作流开始。
这套社区节点仍标为开发中,仓库以 ComfyUI 0.42 验证,要求至少 32GB 系统内存、约 27GB 权重空间。作者实测显卡是 4090,12GB、16GB 是限制显存预算的模拟测试;不能直接当成所有同容量显卡的实机保证。本站也还没有跑过这套接入。
想看研究细节,官方还提供了 280 个案例的测试集,以及 10 月 26 日更新的 技术报告。普通体验先从网页开始就行,不用先把这些读完。
自己部署,先分清要的是视频还是完整网页
官方有单张 RTX 4090 的离线生成方案。它用 INT8 生成模型、FP8 解码器和 CPU 卸载来降低显存占用,需要 Linux、兼容的 NVIDIA 驱动、Docker 与 NVIDIA Container Toolkit。
两份量化权重合计就约 18.2GB,另有文本编码器和 Docker 镜像,系统内存也要装得下卸载的模型。这里“单卡”说的是这套 4090 配置,不能只按显卡数量推断硬件门槛。
如果要搭出官网那种完整交互页面,还要处理 Nomas-PE 提示词服务、前端和网关。Nomas-PE 另外需要 GPU 资源,部署说明在 apps/README。先跑出一段离线视频,再搭整套服务,会更容易定位问题。
有 RTX 4090,想本地跑一次,再展开这些步骤(Linux / Bash)
本节依据 2026-10-25 的官方文档和 代码版本 911cea6整理,本站未用 4090 实机运行。默认配置为 720×1280、24 FPS、8 步生成、随机种子 42;耗时和峰值显存以实际运行记录为准。
1. 下载代码,进入官方 Docker 环境
在已装好 NVIDIA Container Toolkit 的 Linux 主机运行。此示例假设主机只有一张 GPU;多卡主机请让容器只看到要使用的一张卡。
git clone https://github.com/Tencent-Hunyuan/Hy-Nomas.git
cd Hy-Nomas
git checkout 911cea6458a89c2663513ff7099561ec190dd491
docker pull hynomasoss/hynomasoss:cu130
docker run --rm -it --gpus all --ipc=host --network=host \
  -v "$PWD:/workspace/Hy-Nomas" \
  -w /workspace/Hy-Nomas \
  hynomasoss/hynomasoss:cu130 bash
进入容器后,后面的命令都在同一个终端、同一个代码目录继续运行。这些是 Bash 命令,不能直接贴到 Windows PowerShell。
2. 下载单卡权重和官方示例
python -m pip install -U huggingface_hub
export HY_NOMAS_MODEL_DIR="$PWD/checkpoints"
hf download tencent/Hy-Nomas --local-dir "$HY_NOMAS_MODEL_DIR" \
  --include 'DiT/distilled_int8/*' 'VAE/PixelUMM_FT_FP8/*' 'examples/*'
这条命令只取单卡配置所需的两类量化权重和示例。默认文本编码器为 Qwen/Qwen2.5-VL-7B-Instruct,首次启动还会按需下载;下载机要能访问 Hugging Face。
3. 准备 4090 解码所需的 CUTLASS
单卡配置启用了 CUTLASS FP8 解码。当前实现要求源码中有 Ada GemmBlockwise(example 94)对应头文件:
mkdir -p third_party
git clone --depth 1 https://github.com/NVIDIA/cutlass.git third_party/cutlass
export CUTLASS_PATH="$PWD/third_party/cutlass"
test -s "$CUTLASS_PATH/include/cutlass/gemm/device/gemm_blockwise.h" && echo "CUTLASS ready"
最后一行应输出 CUTLASS ready。对应依赖检查可查看 项目的 CUTLASS 加载代码;首次运行可能需要编译 CUDA 内核。
4. 用官方示例生成第一段视频
bash scripts/inference/inference_from_config.sh configs/experiment/single_gpu_low_mem_inference.yaml \
  dit_weight="$HY_NOMAS_MODEL_DIR/DiT/distilled_int8/diffusion_pytorch_model_ema_0_995_int8.safetensors" \
  model.vae.checkpoint="$HY_NOMAS_MODEL_DIR/VAE/PixelUMM_FT_FP8/diffusion_pytorch_model_fp8.safetensors" \
  inference.prompt="$HY_NOMAS_MODEL_DIR/examples/prompts.json" \
  inference.save_path=./outputs/single_gpu
成功后应在 outputs/single_gpu 下找到生成视频,也会保存提示词和中间数据。这个目录映射到主机的 Hy-Nomas 代码目录,退出容器后仍能找到。
先跑通官方示例,再改自己的内容。自定义提示词需要按模型卡中的 JSON 格式保存,并把 inference.prompt 换成那个文件的路径。
- 提示 SP_SIZE 必须匹配 GPU 数量:检查是否误用了默认八卡的
inference.yaml,单卡应使用上面的single_gpu_low_mem_inference.yaml。 - 提示 Set CUTLASS_PATH:检查环境变量是否指向完整 CUTLASS 源码,以及上面的头文件检查是否通过。
- 显存不足:检查是否用了 INT8 DiT 与 FP8 解码器这一对权重,并关闭其他占显存程序;分辨率、片段长度和历史缓存都会影响占用。
Hy-Nomas 最让人想继续玩的,是那种“下一段还可以这样拍”的余地。先把一个小场景接顺,再让故事拐个弯;熊猫的滑翔伞,就是在第四轮才出现的。
如果你要的是一条按分镜完成的短片,也可以对照 可灵 4.0 的参考图与关键帧用法。选哪个,取决于你想先规划整段镜头,还是看着结果继续安排剧情。
2026-10-28 更新:重写正文,复核官方仓库、模型卡与 Demo,补充 WanGP、ComfyUI 入口。截图与离线部署步骤保留 10-25 的核对记录;未运行本地生成、社区集成或性能测试。