让 AI 改代码,最磨人的一段常常是等待:读完文件等一轮,改完等一轮,测试报错再等一轮。小问题来回折腾几次,注意力也被打断了。
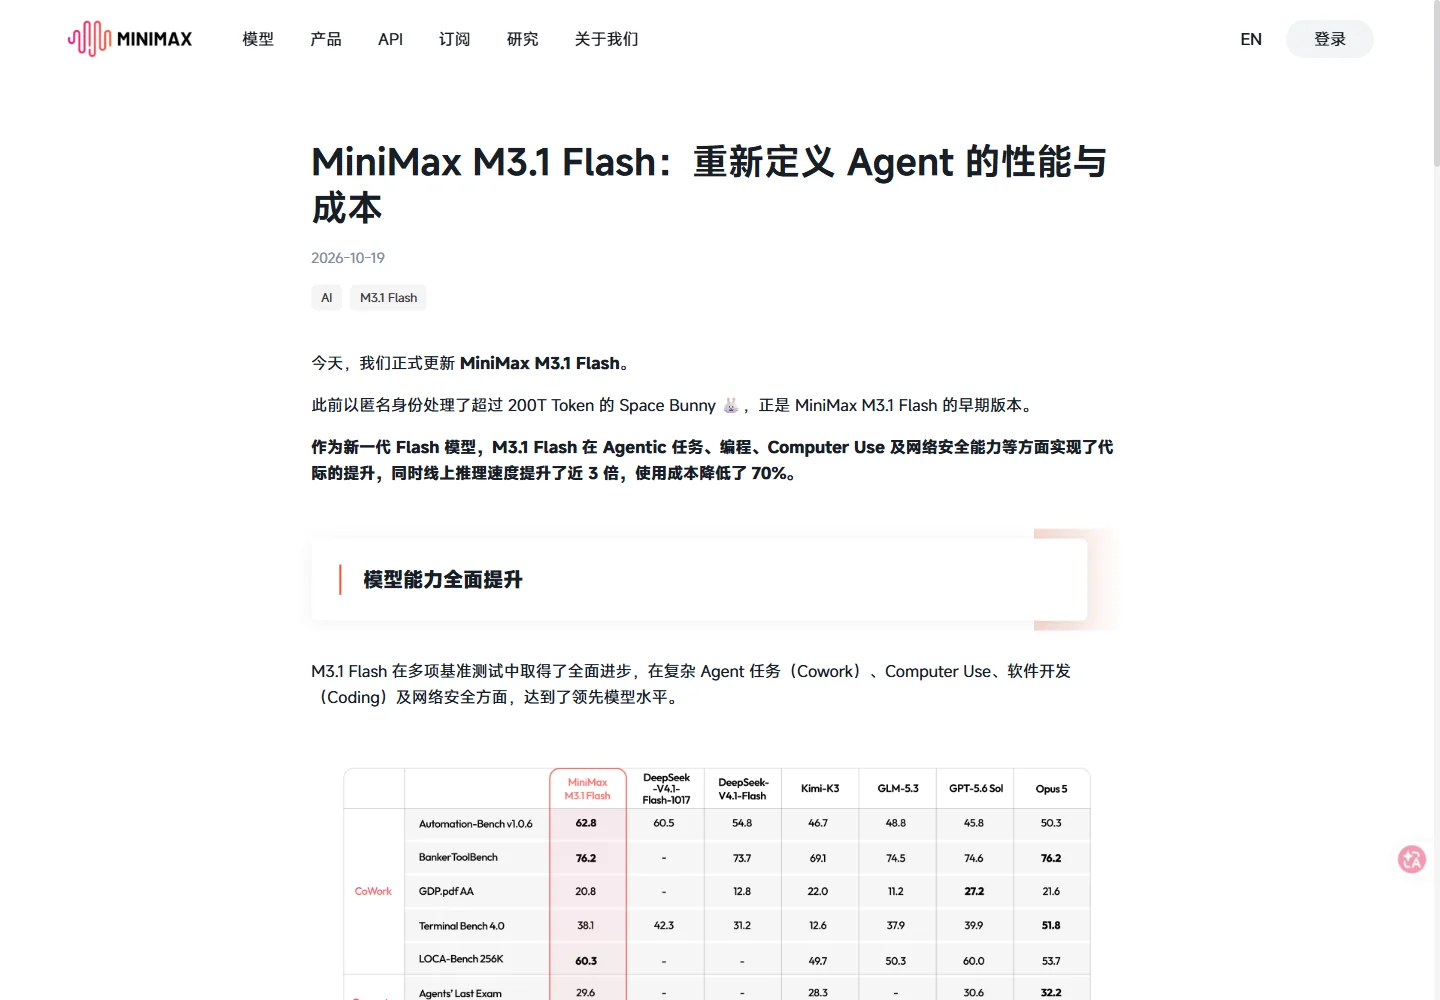
所以 MiniMax M3.1 Flash 这次的 200+ token/s,是个值得留意的数字。MiniMax 在 10 月 19 日公告中说,日常输出可达这个速度,中位数为 170+ token/s,线上推理速度接近上一代的三倍。它瞄准的正是编程和需要连续调用工具的任务。
如果能力跟得上,少等几轮,做事的节奏就会很不一样。但先别把 200 token/s 理解成“每秒写 200 个汉字”,更别理解成“整个任务三倍快”。它描述的是输出速度,读文件、思考、执行工具和测试都还要时间。
快之外,我更关心它能不能把活收尾
“这段代码可能有问题”和“找到了问题,改好了,测试也跑过了”,差着不少工作。M3.1 Flash 的看点,就在于它面向这种连续处理的过程做了优化。
官方给出的 DeepSWE v1.1 成绩是 73.7%。这项评测涉及理解代码、开发功能、修复问题和测试验证,可以用来观察软件任务的完成能力。成绩与速度均来自 MiniMax 发布公告,本站没有做同条件对比测试。
我更建议拿一个自己熟悉的小问题试它。模型榜单再漂亮,也不如它能不能修好你手上那个报错来得直接。
先装客户端,给它一个有答案可核对的小任务
到 MiniMax Code 官方下载入口,选 Windows 或 macOS。入口目前会转到产品页,向下找到“桌面端”就能选系统。安装、登录后,查看账号的模型选项和额度,确认使用的是 M3.1 Flash。
要修本地项目,就选择那个项目文件夹,并把报错原文贴进去。第一次可以这样说:
先读这个项目,找到下面报错的原因。只修改解决这个问题需要的文件,运行项目已有的测试。最后列出改动、测试结果和还没确认的问题。报错是:【粘贴完整报错】。
重点看三样:它有没有真的读相关文件,修复有没有扩大到无关地方,所谓“通过”有没有测试输出。没跑测试就说成功,速度再快也省不了心。
不写代码也能试。比如给它几份会议记录,让它按负责人整理待办,并为每条保留原文出处。网页版可以直接做在线任务;需要本地文件和电脑工具时,桌面端更合适。
官方文档还列出了图片、视频输入和 100 万 token 上下文。材料装得下是一回事,重点找得准是另一回事。第一轮先用你能检查的小份材料,别急着把整个资料库都塞进去。
已经有常用工具,就接 API
如果客户端支持 OpenAI 兼容接口,新增自定义提供商,填这三项:
| 设置项 | 中国站配置 |
|---|---|
| Base URL / 接口地址 | https://api.minimax.cn/v1 |
| 模型名 | MiniMax-M3.1-Flash |
| API Key | 在 MiniMax 开放平台取得的、与所选计费方式对应的密钥 |
保存后先发一句“用一句话解释什么是 API”,看看有没有回复,再去平台核对用量。国际站账号使用 https://api.minimax.io/v1,地址和密钥要配套。协议与参数以 官方调用文档为准。
还有个容易忽略的设置:M3.1 Flash 默认是 max 思考档位。支持调节的客户端里,简单任务可以从 low 试起。OpenAI 兼容接口用 reasoning_effort,允许 low、medium、high、xhigh、max,不能用 none 关闭思考。别因为漏看这个选项,就拿一次长时间思考去判断输出速度。
费用怎么算,以及“下载”到底下载了什么
中国站按量 API 公布的每百万 token 单价为:输入 1 元、输出 4 元、缓存读取 0.1 元。20 万普通输入加 5 万计费输出,按这组单价算约 0.40 元。这里只是算术例子,实际用量还要看请求和返回,调用前复核 官方价格页。
MiniMax Code 的订阅额度和按量 API 各有规则,不要把客户端套餐直接当成 API 余额。
安装 MiniMax Code 得到的是客户端,模型仍在云端计算。10 月 19 日公告把开放权重列为后续计划;这篇介绍的是已经可进入的云端使用方式。想在自己的显卡上离线运行模型,可以看本站的 12GB 显卡运行 Bonsai 27B 记录。
真要判断它是否适合自己,挑那个反复卡住的小任务就够了。让它完成一遍,把修改和测试摆在眼前,值不值得留下来用,会比盯着速度数字清楚得多。
2026-10-28 复核发布公告、调用文档和下载入口。文中任务是上手示例,未执行付费 API 测速或排名测试。